产品链接:GMSL2注入板卡 - 卡朗仿真科技 产品:卡朗仿真 CH2(caronsim_hil_v2.0),面向自动驾驶、具身智能 HIL 硬件在环测试,实现单张 PCIe 板卡 12 路 GMSL1/GMSL2 视频注入,替代传统 2 张 8 路板卡方案,节约机箱 PCIe 插槽,降低台架整体成本。
在自动驾驶 HIL 视频注入领域,市面上主流板卡大多上限为单卡 8 路 GMSL2 注入,想要实现 12 路通道往往需要两张板卡协同。CH2 板卡实现单卡 12 路,不只是简单把通道数量增加,而是从硬件架构、PS‑PL 内存分配、DDR 访问调度、上位机 PCIe 写入策略、FPGA逻辑优化五个维度,系统性解决多路高清原始视频大流量并发难题。
先看真实业务带宽压力
我们选取智驾 HIL 非常典型的相机负载作为测算案例:4 路 4K@30fps + 8 路 2K@30fps,YUV422 / RAW12 原始图像。 原始图像没有压缩,带宽计算公式:
3840×2160×2×30×4 + 1920×1080×2×30×8 = 2985984000 Byte/s,约等于3 GB/s原始视频吞吐流量。
12 路同时工作时,系统面临双重压力:
上位机通过 PCIe 源源不断把图像帧写入板卡 DDR4;
FPGA 内部多路 VDMA 并行从 DDR4 读出图像,输出 GMSL2 视频流给待测域控制器。
最大的瓶颈往往不是 PCIe 标称带宽,而是多路并发下 DDR 内存读写争抢冲突。写操作来自 PCIe,读操作供给 12 路视频通道,调度稍有不当,就会出现通道排队、帧撕裂、丢帧、图像花屏。
五大核心设计,支撑单卡 12 路大流量输出
原因一:硬件底座:3 组独立 DDR4、XCZU19EG FPGA、PCIe3.0×16 打底
CH2 板卡硬件层面打好带宽基础:
主控采用赛灵思 UltraScale+ XCZU19EG 百万门级高性能 FPGA,足够承载 12 路 GMSL 协议栈、VDMA、VTC 时序、IIC 模拟握手等全套复杂逻辑;
12 片 DDR4‑2400MHz,合计 12GB,物理划分为3 组独立 DDR 内存,每组 64bit、4GB,每组独立负责 4 路视频,把 12 路流量物理拆分,避免全部通道抢占同一内存控制器;
PCIe3.0 x16,理论带宽可达 16GB/s,远大于示例业务约 3GB/s 实际负载,为突发流量留有充足余量。
原因二:PS 端与 PL 端 DDR 差异化分工,匹配各自带宽能力
Zynq UltraScale+ MPSoC 架构中,PS 处理器侧 DDR 控制器带宽天生弱于 PL 可编程逻辑侧的 MIG 控制器,很多竞品方案容易踩坑,把高流量通道挂载到 PS‑DDR,直接造成性能瓶颈。
CH2 做了资源的定向分配:
PS 侧的一组 DDR 带宽有限,专门用于存取4 路 2K 相机数据,匹配较低流量负载;
剩余两组 DDR 全部交给 PL 端,利用 PL 更高的内存带宽承载其余高负载通道。
通过分工,不强行将大流量塞入 PS 侧,充分发挥三组 DDR 各自能力,避免 PS 控制器成为系统短板。
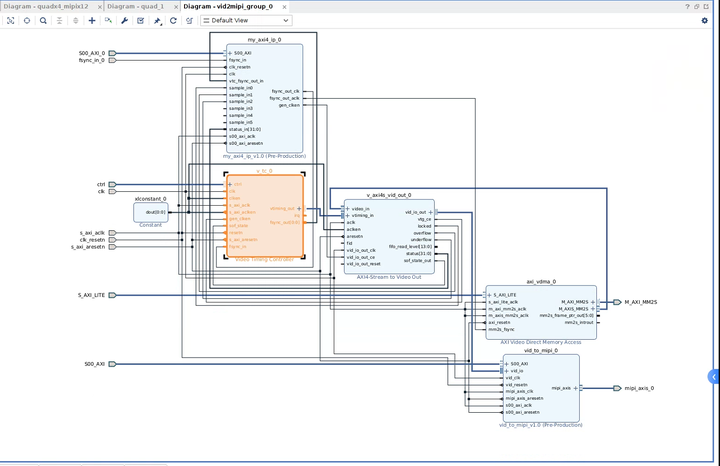
原因三:FPGA 内部时序调度:VDMA 读取后延时几十行像素时钟再触发 VTC IP
DDR4 同时承受 PCIe 写入与多路 VDMA 读取,当 fsync 帧同步信号到来,如果所有通道 VDMA 立刻同时发起 DDR 读请求,多路 VDMA 会激烈竞争 DDR 读端口,部分通道陷入排队等待,引发行卡顿、图像撕裂、丢帧。
CH2 固件采用关键优化策略:
在 fsync 帧同步到来,VDMA 启动 DDR 读取之后,延时几十行像素时钟,再触发 VTC 视频时序 IP。
通过行级时序错开,把 12 路 VDMA 对 DDR 的读访问在时间轴打散,消除同一时刻的读请求风暴,解决 DDR 读资源竞争,保障全部通道稳定输出完整图像,不会出现个别通道饥饿排队。
原因四:上位机 PCIe 写入策略区分 HIL‑Replay 与 HIL‑Sim 两种场景
上位机向板卡 DDR 做 PCIe 写入,同样会带来带宽争抢,针对两种典型 HIL 业务采用两套写入逻辑:
HIL‑Replay(回放开环):场景对实时性约束相对宽松,在单帧周期 33.333ms 时间窗口之内,12 路视频帧轮流写入板卡内存,规避多路同时爆发 PCIe 写请求,减少总线冲击;
HIL‑Sim(WorldSim 闭环仿真):域控硬件触发,对实时性要求极高,不能简单等待轮流。此时将每一路图像拆分为 N 个阶段,分阶段完成 PCIe 写入,兼顾实时性与总线压力。
原因五:FPGA 内部 VDMA/VTC/DDR 参数优化,在逻辑资源允许条件下最大化配置
FPGA 内部 IP 参数直接影响吞吐能力,CH2 在 BRAM、逻辑资源许可前提下做最大化配置:
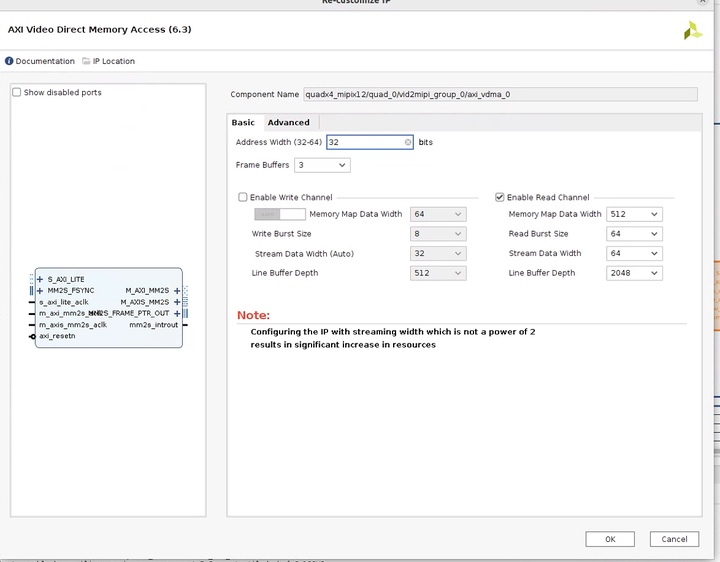
DDR 侧 VDMA 内存映射位宽配置到512bit,更大 AXI 位宽可以提升单次 DDR 突发传输效率,提升整体读写吞吐;
Line Buffer Depth(行缓冲深度)尽可能拉大,依靠更大行缓存吸收读写之间的抖动,平滑流量波动,缓解 DDR 访问瞬时压力。
注意:位宽与行缓冲深度不能无限制增大,受 FPGA 内部逻辑、BRAM 资源上限约束,需要在资源消耗与性能之间做工程取舍。
下图为 CH2 方案中 VDMA IP 配置界面,可以看到 Memory Map Data Width 配置为 512bit,Line Buffer Depth 设置为 2048: